Laporan penjualan bulanan saya timeout, padahal datanya baru 40 ribu baris. Setelah dibongkar, penyebabnya dua: tabel orders menyimpan product_names berupa teks 'Semen, Pasir, Besi' yang tidak bisa di-join, dan kolom total di tabel itu sudah tidak cocok dengan jumlah baris order_items sejak enam bulan lalu. Selisihnya kecil, tiga persen, cukup untuk membuat angka rapat bulanan tidak pernah ketemu.
Skema database seperti itu tidak rusak dalam semalam. Dia jadi begitu pelan-pelan, lewat keputusan kecil yang diambil cepat: kolom tambahan biar tidak perlu join, teks gabungan biar tidak perlu tabel relasi, angka hasil hitung disimpan biar halaman cepat. Semuanya terasa benar saat ditulis, dan semuanya jadi warisan yang menakutkan untuk disentuh tiga tahun kemudian.
Filosofi yang saya pakai sekarang cuma satu kalimat: normalisasi sampai sakit, denormalisasi sampai jalan. Mulai dari model yang benar, buktikan dengan data nyata di bagian mana yang memang lambat, lalu bengkokkan aturannya di titik itu saja, dengan cara yang bisa dipertanggungjawabkan.
Artikel ini PostgreSQL-first, karena di situlah detailnya paling penting. Prinsipnya berlaku umum, dan saya sebut perbedaan MySQL di bagian yang memang mengubah keputusan.
Normalisasi dulu, dan pahami kenapa
Normalisasi bukan upacara akademik. Setiap bentuk normal menghapus satu kelas anomali, yaitu bug update, insert, dan delete yang muncul karena satu fakta disimpan di dua tempat.
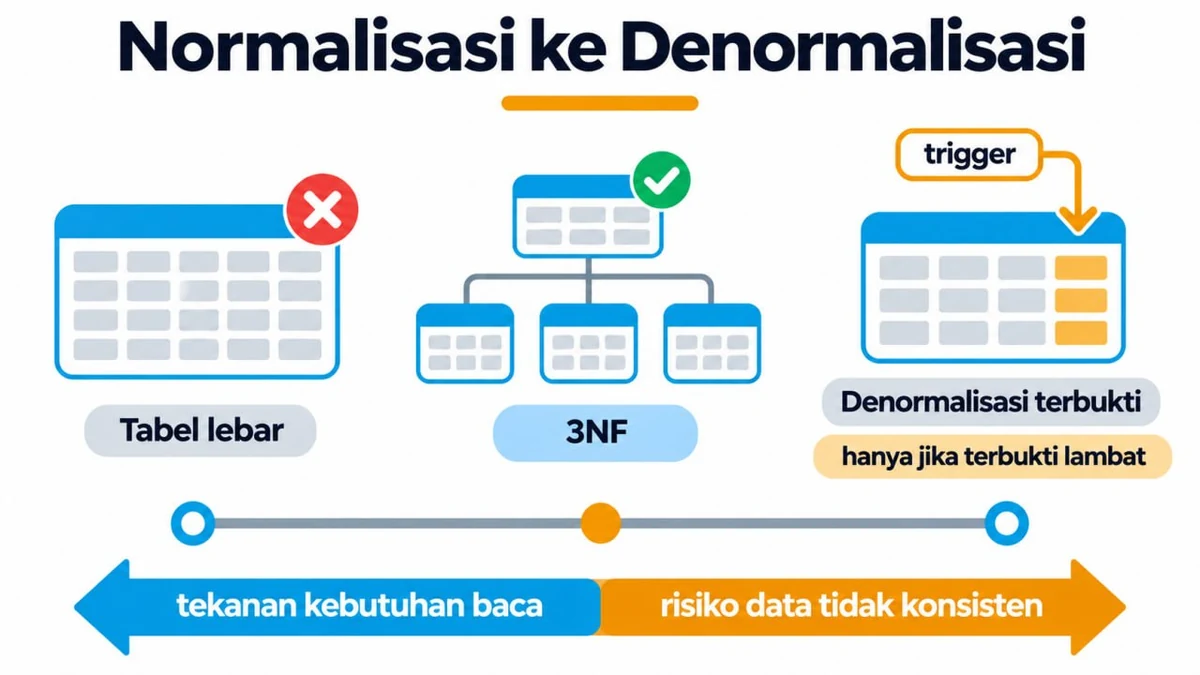
Bentuk yang salah, satu tabel lebar
-- JANGAN: semuanya ditumpuk di orders
CREATE TABLE orders (
    id            BIGINT PRIMARY KEY,
    customer_name TEXT,     -- diulang di setiap order
    customer_email TEXT,    -- diulang, dan sekarang mana yang benar?
    product_names TEXT,     -- 'Semen, Pasir, Besi' -- CSV, tidak bisa di-query
    total         NUMERIC
);
Ada tiga bug yang sudah tertanam di situ. Ganti email pelanggan, kamu harus memperbarui semua baris order miliknya (anomali update). Pelanggan yang belum pernah order tidak bisa disimpan (anomali insert). Hapus order terakhirnya, pelanggannya ikut hilang (anomali delete). Ditambah daftar produk dalam bentuk CSV yang tidak bisa di-join ke tabel mana pun.
Versi ternormalisasi
CREATE TABLE customers (
    id    BIGINT PRIMARY KEY,
    name  TEXT NOT NULL,
    email TEXT NOT NULL UNIQUE
);

CREATE TABLE products (
    id          BIGINT PRIMARY KEY,
    name        TEXT NOT NULL,
    price_cents BIGINT NOT NULL
);

CREATE TABLE orders (
    id          BIGINT PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers(id),
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_items (
    order_id    BIGINT NOT NULL REFERENCES orders(id),
    product_id  BIGINT NOT NULL REFERENCES products(id),
    quantity    INT    NOT NULL CHECK (quantity > 0),
    price_cents BIGINT NOT NULL,   -- harga SAAT order dibuat
    PRIMARY KEY (order_id, product_id)
);
Setiap fakta tinggal di satu tempat. Tiga bentuk normal dalam satu tarikan napas:
- 1NF: nilai atomik, tidak ada kelompok berulang. Tidak ada kolom CSV, tidak ada
phone1,phone2,phone3. - 2NF: tidak ada ketergantungan sebagian pada bagian dari kunci komposit.
- 3NF: tidak ada ketergantungan transitif. Kolom non-kunci hanya bergantung pada kunci.
Sembilan puluh lima persen pekerjaanmu berhenti di 3NF. Di situ titik seimbangnya: benar, lentur, dan cukup cepat untuk hampir semua beban kerja.
Perhatikan satu pengecualian yang sengaja: order_items.price_cents. Harga adalah milik tabel products, jadi menyalinnya terlihat seperti pelanggaran normalisasi. Sebenarnya bukan. Yang kamu simpan adalah fakta pada satu titik waktu. Harga saat order dibuat memang data yang berbeda dari harga sekarang, dan ketika harga produk naik minggu depan, order lama tidak boleh ikut berubah. Kebiasaan membedakan "nilai sekarang" dan "nilai saat kejadian" adalah salah satu insting pemodelan paling berguna yang bisa kamu latih.
Dasar yang menentukan sebelum trik apa pun
Masalah performa biasanya masalah dasar yang menyamar. Kalau bagian ini beres, sebagian besar keluhan lambat tidak pernah muncul.
Pilih kunci dengan sadar
-- BIGINT identity: ringkas, berurutan, ramah index
id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY

-- UUID: unik global, berguna untuk sistem terdistribusi dan merge data
-- tapi UUIDv4 acak memecah lokalitas index saat insert
-- pakai UUIDv7 (berurutan waktu) kalau butuh UUID pada volume besar
id UUID PRIMARY KEY DEFAULT gen_random_uuid()
Default saya BIGINT identity, kecuali ada alasan konkret untuk UUID: ID dibuat di sisi klien, penggabungan data antar wilayah, atau tidak ingin jumlah baris terbaca dari ID. Kalau memang perlu UUID pada volume insert tinggi, pakai varian yang berurutan waktu supaya B-tree tidak tercabik.
Paksa aturan di level skema
Database adalah garis pertahanan terakhir untuk integritas. Pemeriksaan di aplikasi gampang dilewati skrip, migrasi, dan service berikutnya.
ALTER TABLE order_items ADD CONSTRAINT qty_positive CHECK (quantity > 0);
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
ALTER TABLE orders ADD CONSTRAINT fk_customer
    FOREIGN KEY (customer_id) REFERENCES customers(id);
Skema yang menegakkan aturannya sendiri adalah skema yang bisa kamu percaya jam tiga pagi. Saya lebih suka penulisan buruk gagal berisik di database daripada data rusak lewat dengan tenang.
Tipe data yang benar
amount     NUMERIC(12,2)  -- uang: presisi eksak, jangan FLOAT
created_at TIMESTAMPTZ    -- selalu sadar zona waktu, simpan UTC
status     TEXT NOT NULL  -- dijaga CHECK atau FK ke tabel lookup
Uang pakai NUMERIC, karena floating point biner tidak bisa mewakili 0,10 dengan tepat. Waktu pakai TIMESTAMPTZ, bukan TIMESTAMP, dan simpan dalam UTC. Di Postgres, pakai TEXT alih-alih VARCHAR(n) yang panjangnya dikarang, dan pakai ENUM atau tabel lookup alih-alih string ajaib.
Index untuk query yang benar-benar kamu jalankan
Index adalah taruhan bahwa sebuah query akan memfilter atau mengurutkan pada kolom itu. Pasang berdasarkan pola akses nyata, bukan dugaan.
-- Foreign key: index sendiri. Postgres TIDAK otomatis meng-index FK.
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- Index komposit untuk filter + urutan. Urutan kolom berpengaruh:
-- kolom kesetaraan dulu, baru kolom rentang atau urutan.
CREATE INDEX idx_orders_cust_created ON orders (customer_id, created_at DESC);

-- Partial index: hanya baris yang kamu query, lebih kecil dan lebih cepat
CREATE INDEX idx_orders_open ON orders (created_at) WHERE status = 'open';
Dua hal yang sering terlewat. PostgreSQL tidak meng-index foreign key secara otomatis, berbeda dari MySQL InnoDB, dan FK tanpa index membuat join serta delete berantai jadi lambat. Setiap index juga menambah beban saat menulis, jadi jangan meng-index kolom yang tidak pernah kamu filter. Ukur dengan EXPLAIN ANALYZE, jangan menebak.
Kapan aturan boleh dibengkokkan
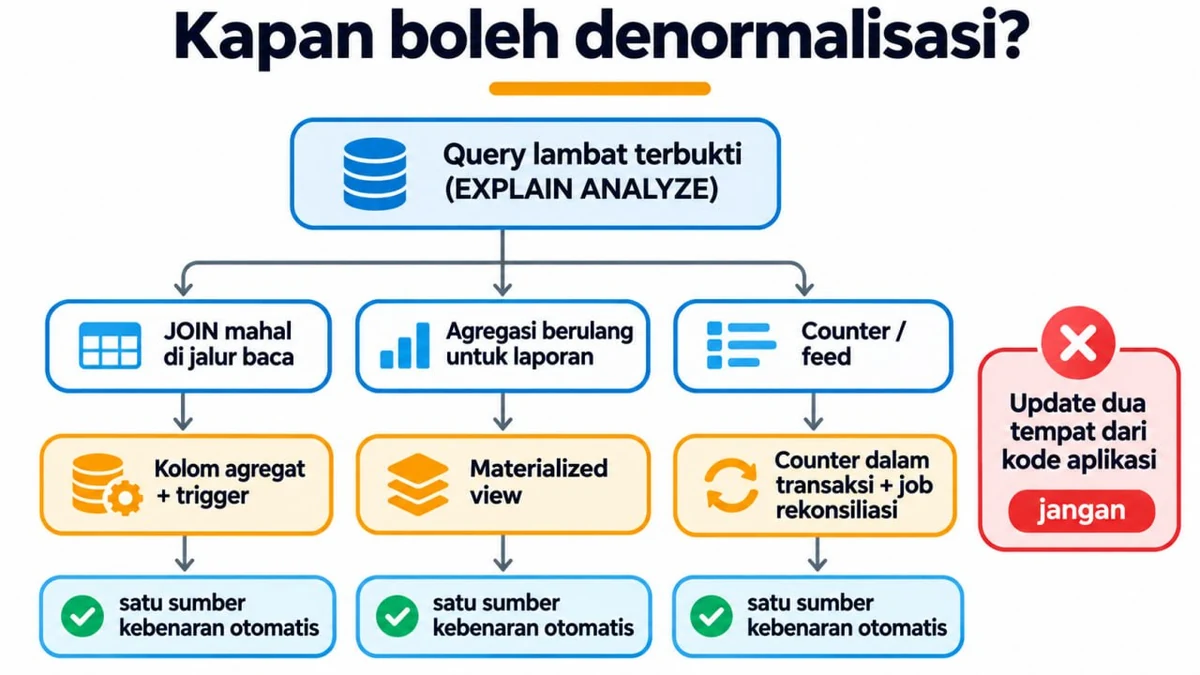
Posisi saya: denormalisasi hanya ketika ada bukti, dan data rangkapnya harus merawat dirinya sendiri. Denormalisasi yang terlalu cepat adalah cara paling rapi untuk mendapatkan jawaban cepat yang salah.
Sinyal 1: join memang terlalu mahal saat dibaca
Kamu menghitung total order dengan menjumlahkan order_items di setiap pembacaan, dan jalur itu terbukti panas. Simpan agregatnya, tapi jaga kejujurannya dengan trigger, bukan dengan mengandalkan ingatan aplikasi.
ALTER TABLE orders ADD COLUMN total_cents BIGINT NOT NULL DEFAULT 0;

CREATE OR REPLACE FUNCTION refresh_order_total() RETURNS TRIGGER AS $$
BEGIN
    UPDATE orders o
       SET total_cents = (
           SELECT COALESCE(SUM(quantity * price_cents), 0)
             FROM order_items
            WHERE order_id = o.id
       )
     WHERE o.id = COALESCE(NEW.order_id, OLD.order_id);
    RETURN NULL;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER trg_order_total
AFTER INSERT OR UPDATE OR DELETE ON order_items
FOR EACH ROW EXECUTE FUNCTION refresh_order_total();
Aturan yang menjaga denormalisasi tetap aman: data rangkap harus punya satu sumber kebenaran otomatis. Trigger, materialized view, atau jalur tulis yang dijaga ketat. Bukan "nanti aplikasi yang memperbarui keduanya". Begitu ada dua jalur kode yang bisa menulis fakta yang sama, keduanya akan menyimpang.
Sinyal 2: laporan berat yang menghantam agregasi yang sama
Untuk kasus ini, materialized view. Ini denormalisasi yang dikelola database untukmu.
CREATE MATERIALIZED VIEW daily_revenue AS
SELECT date_trunc('day', created_at) AS day,
       SUM(total_cents)               AS revenue_cents,
       COUNT(*)                       AS order_count
  FROM orders
 GROUP BY 1;

CREATE UNIQUE INDEX ON daily_revenue (day);  -- syarat REFRESH CONCURRENTLY

REFRESH MATERIALIZED VIEW CONCURRENTLY daily_revenue;
Ini alat denormalisasi favorit saya karena eksplisit, terisolasi, dan mudah dibangun ulang. Kalau isinya salah, satu REFRESH dan benar lagi. MySQL tidak punya materialized view bawaan; di sana kamu meniru dengan tabel ringkasan plus INSERT ... SELECT terjadwal atau trigger.
Sinyal 3: counter dan feed
Jumlah pengikut, jumlah suka, feed aktivitas. Menghitung ulang dari nol di setiap request tidak akan bertahan. Simpan kolom counter yang diperbarui dalam transaksi yang sama dengan kejadiannya, atau hitung feed lebih dulu. Ini denormalisasi sah untuk pola akses yang terukur. Meski begitu, tetap pasang job rekonsiliasi terjadwal yang menghitung ulang nilai sebenarnya, supaya penyimpangan menyembuhkan diri sendiri.
Bentuk denormalisasi, diurutkan dari yang paling saya percaya
| Bentuk | Siapa yang menjaga kebenaran | Kapan dipakai |
|---|---|---|
| Materialized view | database | laporan dan agregasi berulang |
| Kolom agregat dengan trigger | trigger, satu-satunya penulis | total, saldo, jumlah baris |
| Salinan kolom untuk fakta titik waktu | desain, bukan duplikasi | harga, alamat, status saat kejadian |
| Data rangkap dirawat di kode aplikasi | tidak ada | hindari, kecuali tiga di atas sudah dicoba |
Rancang untuk berubah
Skema yang menua dengan baik adalah skema yang menyisakan ruang tumbuh.
Soft delete saat riwayat penting
ALTER TABLE customers ADD COLUMN deleted_at TIMESTAMPTZ;

-- unique index parsial: hanya berlaku untuk baris yang masih hidup
CREATE UNIQUE INDEX idx_customers_email_live
    ON customers (email) WHERE deleted_at IS NULL;
Index unik parsial itu trik Postgres yang manis: email harus unik di antara pelanggan aktif, tapi pelanggan yang sudah dihapus boleh mendaftar lagi dengan email yang sama. Coba nyatakan aturan itu dengan rapi tanpa index parsial.
Migrasi harus aman di tabel yang sedang hidup
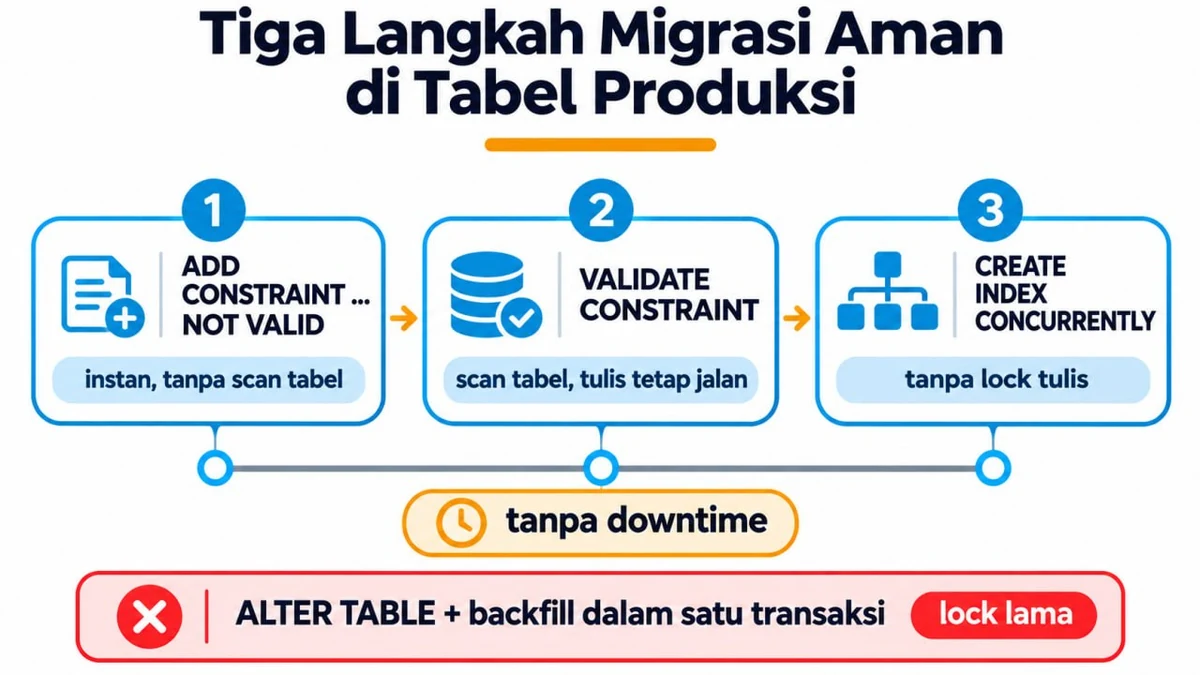
Ini pendapat yang saya pertahankan: jangan pernah menjalankan migrasi yang mengambil lock eksklusif lama di tabel panas. Menambah kolom nullable itu instan di Postgres modern, dan menambah kolom NOT NULL dengan default juga cepat sejak Postgres 11 karena hanya perubahan metadata. Yang berbahaya adalah backfill dan constraint yang memindai seluruh tabel. Kerjakan bertahap:
-- 1. Tambahkan constraint TANPA memindai tabel
ALTER TABLE orders ADD CONSTRAINT chk_total CHECK (total_cents >= 0) NOT VALID;

-- 2. Validasi terpisah: memindai, tapi tidak memblokir penulisan
ALTER TABLE orders VALIDATE CONSTRAINT chk_total;

-- 3. Index di tabel hidup dibangun tanpa lock tulis
CREATE INDEX CONCURRENTLY idx_orders_total ON orders (total_cents);
Di MySQL, andalkan online DDL (ALGORITHM=INPLACE) atau alat seperti pt-online-schema-change dan gh-ost.
Ketika relasional bukan jawabannya
Bersikap tegas itu dua arah. Ada data yang memang tidak ingin jadi baris ternormalisasi.
| Bentuk data | Pilihan | Catatan |
|---|---|---|
| Field kustom per tenant yang benar-benar bebas | kolom JSONB + index GIN | kolom stabil tetap jadi kolom biasa, hanya bagian yang berubah masuk JSONB |
| Hierarki dalam atau data berbentuk graf | recursive CTE, ltree, closure table | untuk beban graf sungguhan, pertimbangkan graph store |
| Time-series append-only berukuran besar | partisi tabel per waktu, atau TimescaleDB | index tetap kecil, arsip lama cukup DROP TABLE |
-- Partisi per waktu: index kecil dan hapus data lama jadi murah
CREATE TABLE events (
    id         BIGINT,
    created_at TIMESTAMPTZ,
    payload    JSONB
) PARTITION BY RANGE (created_at);

CREATE TABLE events_2026_11 PARTITION OF events
    FOR VALUES FROM ('2026-11-01') TO ('2026-12-01');
Partisi adalah tuas scaling yang sering dilupakan. Alih-alih satu tabel 500 juta baris, kamu punya anak tabel bulanan dengan index kecil, dan mengarsipkan data lama jadi satu DROP TABLE alih-alih DELETE raksasa.
Checklist sebelum skema saya sebut selesai
- Sudah 3NF, setiap fakta disimpan satu kali?
- Fakta titik waktu (harga, alamat saat kejadian) disimpan, bukan dicari ulang saat dibaca?
- Semua foreign key terdefinisi dan ter-index?
- Aturan penting ditegakkan constraint (
NOT NULL,CHECK,UNIQUE, FK), bukan hanya di kode aplikasi? - Tipe data benar:
NUMERICuntuk uang,TIMESTAMPTZuntuk waktu? - Index cocok dengan pola query nyata, sudah dicek dengan
EXPLAIN ANALYZE? - Setiap data hasil denormalisasi merawat dirinya sendiri, dengan jalur rekonsiliasi?
- Skema bisa dimigrasi di tabel hidup tanpa lock panjang?
- Sudah menahan diri untuk tidak mendenormalisasi hal yang belum terbukti lambat?
Rancang model bersihnya lebih dulu, karena mendenormalisasi skema yang benar jauh lebih mudah daripada membetulkan skema yang sudah cepat. Biarkan beban kerja nyata yang menentukan di mana aturan dibengkokkan, bukan kecemasan. Dan setiap kali membengkokkannya, serahkan tanggung jawab menjaga kerapian data itu ke database.
Kalau kamu bekerja dengan PostgreSQL dan Laravel, multi-tenancy dengan row level security adalah lanjutan yang masuk akal dari skema seperti ini: setelah bentuk tabelnya benar, pertanyaan berikutnya adalah siapa yang boleh melihat baris mana.